 Warum ich dafür keine Suchmaschine brauche
Eine Frage, die ich mir eigentlich jeden Morgen stelle:
‚Wie ist das aktuelle Wetter heute?‘
Dafür kann ich Alexa fragen, auf meine Smartwatch schauen oder einfach einen Blick auf mein Smartphone werfen.
Und wenn ich sowieso am Windows-PC sitze, steht das Wetter möglicherweise bereits in der Taskleiste. Wozu also eine lokale KI bemühen? – Eigentlich zu gar nichts. Zumindest nicht, wenn ich nur wissen möchte, ob ich heute einen Regenschirm brauche.
Aber die Wetterfrage eignet sich recht gut, um etwas anderes zu zeigen:
Wie kann ich aktuelle Informationen von Webseiten mit meiner eigenen, lokal laufenden KI verarbeiten?
Warum nicht einfach eine Suchmaschine verwenden?
Z-PromptX verfügt inzwischen über mehrere Schnittstellen zu Internetsuchmaschinen. Damit kann auch ein lokales Sprachmodell aktuelle Informationen aus dem Internet erhalten. Über die verschiedenen Möglichkeiten habe ich bereits in meinen Beiträgen Websuche für Ollama und Mit Ollama ins Internet geschrieben. Das funktioniert allerdings nicht immer so zuverlässig, wie man es sich wünschen würde.
Eine Suchmaschine liefert mehrere Treffer, häufig mit unterschiedlichen Informationen. Das Sprachmodell muss entscheiden, welche davon zur eigentlichen Frage passen und welche Angaben tatsächlich relevant sind. Gerade kleinere lokale Modelle haben damit gelegentlich ihre Schwierigkeiten.
Dann werden drei oder vier Fakten korrekt wiedergegeben, während sich das Modell zwei oder drei weitere Angaben einfach ausdenkt. Die Antwort liest sich durchaus überzeugend, nur stimmen leider nicht alle Informationen. Und warum sollte ich überhaupt eine Suchmaschine bemühen, wenn ich bereits weiß, auf welcher Webseite die gewünschten Informationen stehen?
Es geht auch wesentlich einfacher
In Z-PromptX gibt es dafür sogenannte URL-Platzhalter. Nehmen wir als Beispiel die Wetterseite des rbb:
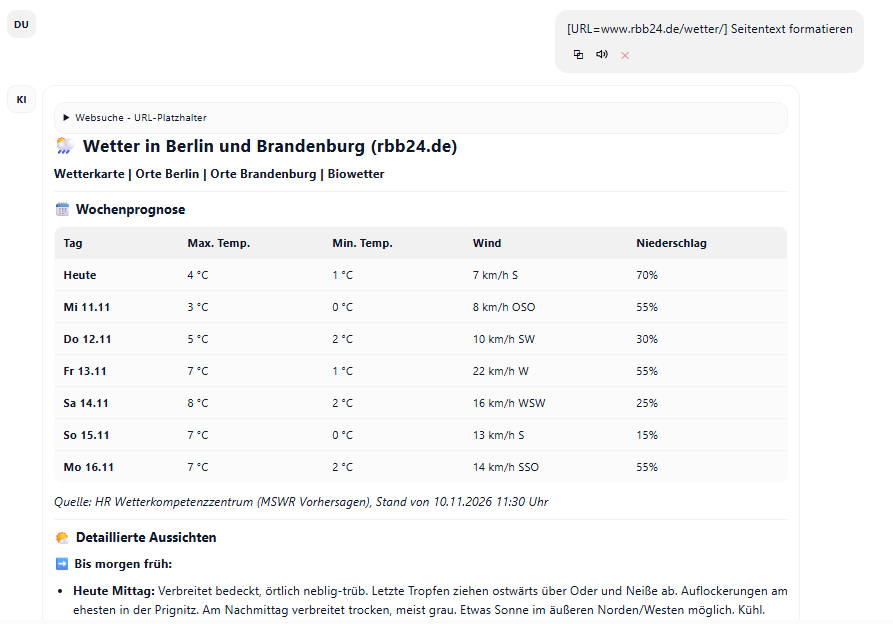
Statt eine Suchmaschine nach dem aktuellen Wetter in Berlin zu befragen, kann ich diese Webseite direkt einlesen und den Inhalt durch mein lokales Sprachmodell aufbereiten lassen. Ein einfacher Prompt reicht:
[URL=www.rbb24.de/wetter/] Seitentext formatieren
Z-PromptX ruft den Seiteninhalt ab und übergibt den bereinigten Text an das ausgewählte Sprachmodell. Das Modell kann daraus beispielsweise eine übersichtliche Tabelle mit den Wetterinformationen erstellen. Es können noch Navigationstexte oder andere Beschriftungen enthalten sein, aber die eigentlichen HTML-Tags und Attribute sind bereits entfernt. Die Suchmaschine bleibt außen vor. Damit entfällt zumindest das Problem, aus mehreren Suchtreffern die passenden Informationen auswählen zu müssen.
Noch interessanter: URLB
Neben dem einfachen URL-Platzhalter gibt es in Z-PromptX eine weitere Möglichkeit:
[URLB=www.rbb24.de/wetter/] Seitentext formatieren
Der Unterschied liegt im Abruf der Webseite.
Während [URL=...] eine Webseite direkt abruft, verwendet [URLB=...] den integrierten Browser beziehungsweise dessen Cache.
Das hat einen entscheidenden Vorteil:
Damit lassen sich auch Webseiten verarbeiten, für die ich mich zuvor anmelden musste.
Viele Webseiten stellen ihre Informationen erst nach einer Anmeldung zur Verfügung. Ein einfacher direkter Abruf der URL reicht dann nicht aus. Mit der Browser-Variante kann Z-PromptX dagegen auch auf Seiteninhalte zugreifen, die im angemeldeten Browser verfügbar sind.
Das eröffnet natürlich wesentlich mehr Möglichkeiten als nur eine Wetterabfrage.
Ob längere Fachartikel, Dokumentationen oder Informationen aus einem geschützten Kundenbereich: Ich kann die Inhalte mit meinem lokalen Sprachmodell zusammenfassen, gezielt Fragen dazu stellen oder sie nach meinen Vorstellungen aufbereiten lassen. Voraussetzung ist natürlich, dass ich selbst Zugriff auf die jeweilige Webseite habe.
Ein Beispiel aus der Praxis: Meine Kindle-Bibliothek
Ein etwas interessanteres Beispiel als der Wetterbericht ist meine Kindle-E-Book-Bibliothek bei Amazon. Die Bücher werden dort mit ihren Covern dargestellt. Das ist für die tägliche Nutzung durchaus praktisch. Möchte ich aber eine übersichtliche Liste meiner Bücher mit Titel und Autor erstellen, sieht die Sache schon etwas anders aus. Natürlich könnte ich die einzelnen Angaben von Hand kopieren. Bei einer größeren Sammlung macht das allerdings wenig Spaß. Also öffne ich die Kindle-Bibliothek im integrierten Browser von Z-PromptX und lasse den Seiteninhalt durch mein lokales Sprachmodell aufbereiten.
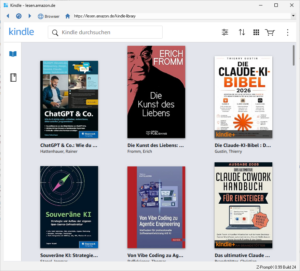
Da die Kindle-Bibliothek eine Anmeldung benötigt, verwende ich dafür die Browser-Variante des URL-Platzhalters.
[URLB=https://lesen.amazon.de/kindle-library]

Erstelle aus den vorhandenen Buchinformationen eine Markdown-Tabelle.
Das lokale Sprachmodell erhält den bereinigten Seiteninhalt und erstellt daraus eine Markdown-Tabelle. Z-PromptX kann diese formatierte Ausgabe direkt anzeigen und über die entsprechende Schaltfläche als PDF-Datei speichern. So wird aus einer Webseite eine übersichtliche PDF-Liste, ohne dass ich die einzelnen Einträge selbst kopieren oder formatieren muss.
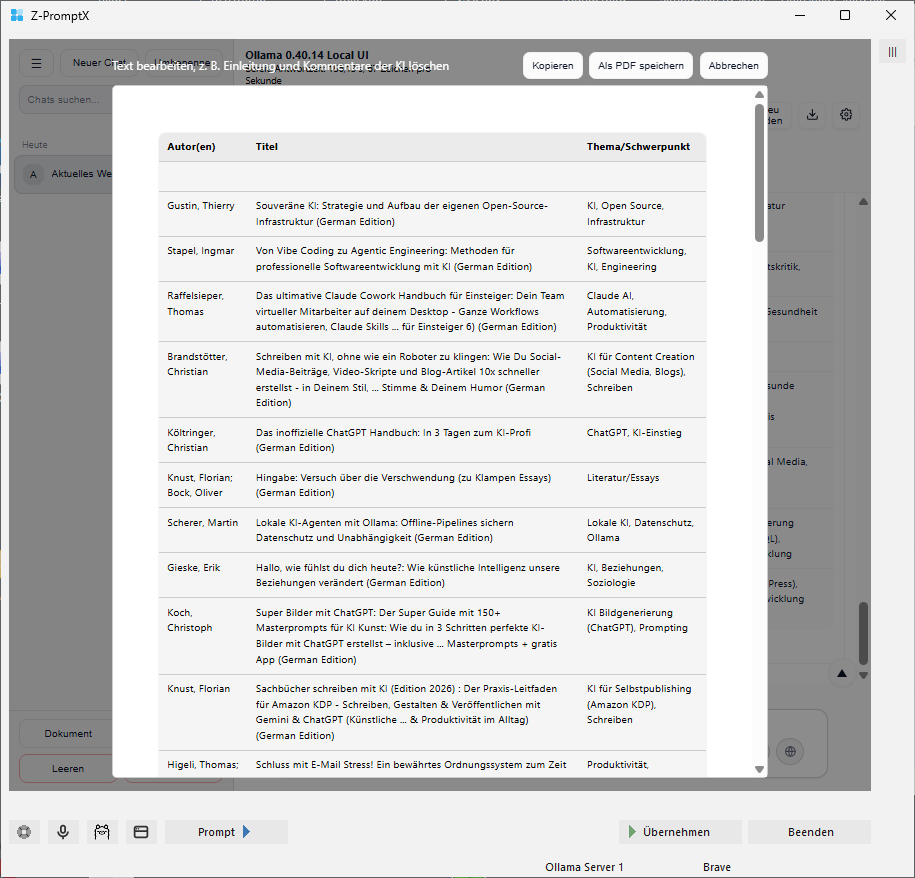
Eine Einschränkung sollte man dabei beachten: Bei größeren Kindle-Bibliotheken werden möglicherweise nicht alle Bücher gleichzeitig auf einer Webseite angezeigt. Gegebenenfalls muss man die Bibliothek deshalb Seite für Seite abarbeiten. Die KI kann schließlich nur die Informationen berücksichtigen, die ihr tatsächlich übergeben werden.
Allerdings zeigt dieses Beispiel auch, wo die Grenzen lokaler Sprachmodelle liegen.
Ein wichtiger Punkt: Die Kontextgröße
Wer Webseiten mit einer lokalen KI auswerten möchte, sollte unbedingt auf die eingestellte Kontextgröße achten.
Sprachmodelle verarbeiten Informationen nicht zeichenweise, sondern in sogenannten Tokens. Wie viele Tokens ein Text benötigt, hängt unter anderem vom verwendeten Modell und dessen Tokenizer ab. Für normale deutschsprachige Texte kann man überschlägig mit etwa drei bis vier Zeichen pro Token rechnen.
| Textumfang | Geschätzter Tokenverbrauch |
|---|---|
| 1.600 Zeichen | 400–550 Tokens |
| 8.000 Zeichen | 2.000–2.700 Tokens |
| 16.000 Zeichen | 4.000–5.500 Tokens |
| 32.000 Zeichen | 8.000–11.000 Tokens |
| 64.000 Zeichen | 16.000–22.000 Tokens |
Die Werte sind nur eine grobe Orientierung. Bei Listen, vielen Zahlen, Sonderzeichen oder ungewöhnlichen Textstrukturen kann der tatsächliche Tokenverbrauch abweichen.
Eine Webseite mit 16.000 Zeichen bereinigtem Text benötigt also möglicherweise bereits 5.000 Tokens. Habe ich in Z-PromptX beispielsweise nur 4.096 Tokens als Kontext eingestellt, reicht das nicht aus.
Denn zum Kontext gehören nicht nur die Informationen der Webseite. Auch der Systemprompt, die eigentliche Benutzerfrage und gegebenenfalls der bisherige Gesprächsverlauf benötigen Platz. Hinzu kommt die Ausgabe des Sprachmodells.
Z-PromptX besitzt außerdem eine einstellbare Größenbegrenzung für eingelesene Webseiteninhalte.
Wird diese Grenze überschritten, schneidet Z-PromptX den restlichen Seiteninhalt ab und vermerkt ausdrücklich, dass der Text gekürzt wurde. Das ist wichtig, denn so kann ich erkennen, dass möglicherweise nicht alle Informationen der Webseite berücksichtigt wurden.
Allerdings darf man diese Begrenzung nicht mit der Kontextgröße des Sprachmodells verwechseln. Auch ein vollständig eingelesener Seitentext kann mehr Tokens benötigen, als das Modell im eingestellten Kontext verarbeiten kann.
Ist der verfügbare Kontext zu klein, können Informationen fehlen. Im ungünstigsten Fall bekomme ich eine ordentlich formatierte Tabelle, in der aber ein Teil der ursprünglichen Daten gar nicht mehr enthalten ist.
Gerade bei umfangreichen Webseiten oder längeren Bücherlisten sollte man deshalb sowohl die Größenbegrenzung für Webseiteninhalte als auch die eingestellte Kontextgröße prüfen.
Das bedeutet übrigens nicht, dass jedes kleine Sprachmodell grundsätzlich nur einen kleinen Kontext verarbeiten kann. Die unterstützte Kontextlänge ist modellabhängig. Ein größer eingestellter Kontext benötigt allerdings auch zusätzlichen Speicher und kann sich auf die Verarbeitungsgeschwindigkeit auswirken.
Wie sich Kontextgröße und Speicherbedarf in Z-PromptX aufeinander abstimmen lassen, habe ich bereits im Beitrag Zwei Ollama-Server und weniger Umwege im Alltag beschrieben.
Und wenn die Webseite bereits geöffnet ist?
Dafür gibt es in Z-PromptX noch eine dritte Variante:
[URLB] Fasse den Inhalt dieser Webseite kurz zusammen.
Habe ich im integrierten Browser bereits eine Webseite geöffnet, brauche ich deren Adresse nicht noch einmal anzugeben.
Der Platzhalter [URLB] übernimmt einfach den Inhalt der aktuell geöffneten Seite.
Das ist eine nette zusätzliche Möglichkeit, gerade wenn ich beim Lesen auf einen längeren Artikel stoße, den ich gerne zusammenfassen oder genauer analysieren möchte.
Die drei URL-Platzhalter im Überblick
| Platzhalter | Funktion |
|---|---|
[URL=Adresse] |
Ruft eine Webseite direkt ab und übergibt den bereinigten Inhalt an das lokale Sprachmodell. |
[URLB=Adresse] |
Verwendet den integrierten Browser beziehungsweise dessen Cache. Damit lassen sich auch Seiten nach einer Anmeldung auswerten. |
[URLB] |
Übernimmt den Inhalt der aktuell im Z-PromptX-Browser geöffneten Webseite. |
Was hat das nun mit lokaler KI zu tun?
Der interessante Punkt ist für mich nicht, dass eine KI einen Wetterbericht schreiben kann. Das können andere Programme schon lange, meistens sogar schneller. Interessant ist vielmehr, dass ich selbst bestimmen kann, welche Informationen meine lokale KI erhält und was sie damit machen soll.
Die Webseite wird zwar aus dem Internet abgerufen. Die anschließende Verarbeitung durch das lokale Sprachmodell erfolgt auf meinem Windows-PC. Die Seiteninhalte müssen dafür nicht an einen externen KI-Dienst übertragen werden.
Natürlich kann auch dabei ein Sprachmodell Fehler machen. Nur weil ich ihm den richtigen Seiteninhalt übergebe, bedeutet das noch lange nicht, dass es jede Information korrekt interpretiert.
Aber ich habe zumindest eine wesentliche Fehlerquelle ausgeschaltet: die eigenständige Suche und Auswahl möglicherweise unpassender Internetquellen. Und das Ganze funktioniert mit einem einfachen Platzhalter im Prompt.
Das Wetter in Berlin war dabei nur ein beliebiges Beispiel. Was ich mit den Informationen einer Webseite anschließend mache, bleibt mir und meinem lokalen Sprachmodell überlassen.
Die Beispiele in diesem Beitrag wurden mit Z-PromptX in der Version 0.99 Build 25 und dem lokalen Sprachmodell nemotron-3.5-bolt:e4b erstellt. Wer Z-PromptX selbst ausprobieren möchte, findet hier meine Installationsanleitung für Z-PromptX mit Ollama.